Зачем нужен плагин?
Самый первый возникающий вопрос: зачем для этого отдельный плагин? Можно открыть Claude (или другой популярный ИИ), например, в браузере и попросить его вести занятие по интересующей вас теме или просто вести свободную беседу. Но, по моему мнению, изучение языка — процесс, достаточно сильно требующий структуры и порядка.
Если создавать плагин для Claude Code (CLI-версии Claude), то открываются большие возможности для построения необходимой логики, хранения долгосрочной памяти и, при необходимости, использования детерминированного программного кода вместо того, чтобы полагаться во всём на LLM.
Заданная структура учёбы
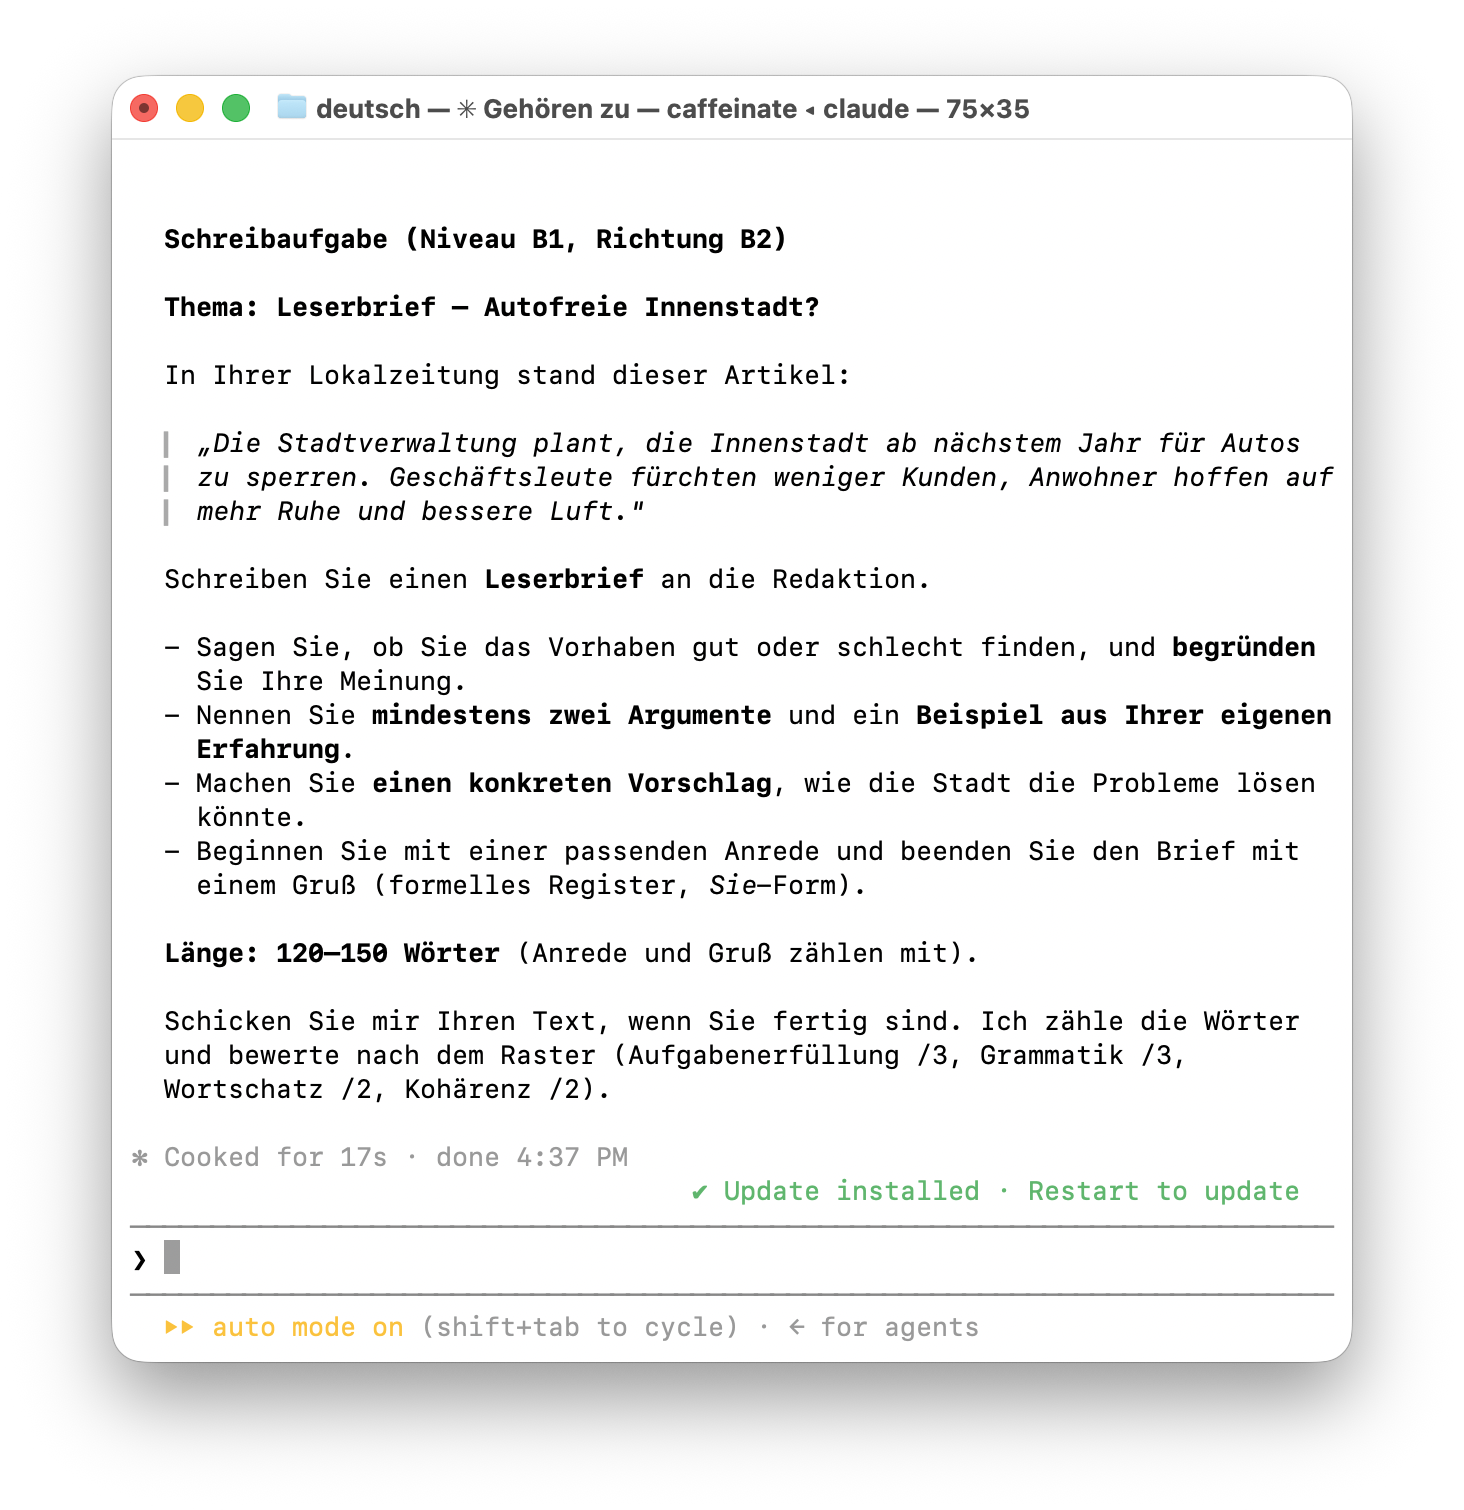
Через плагин я решил практиковать 4 сферы изучения языка: грамматику, чтение, письмо и словарный запас. Говорение, например, я буду практиковать через другие инструменты и методы.
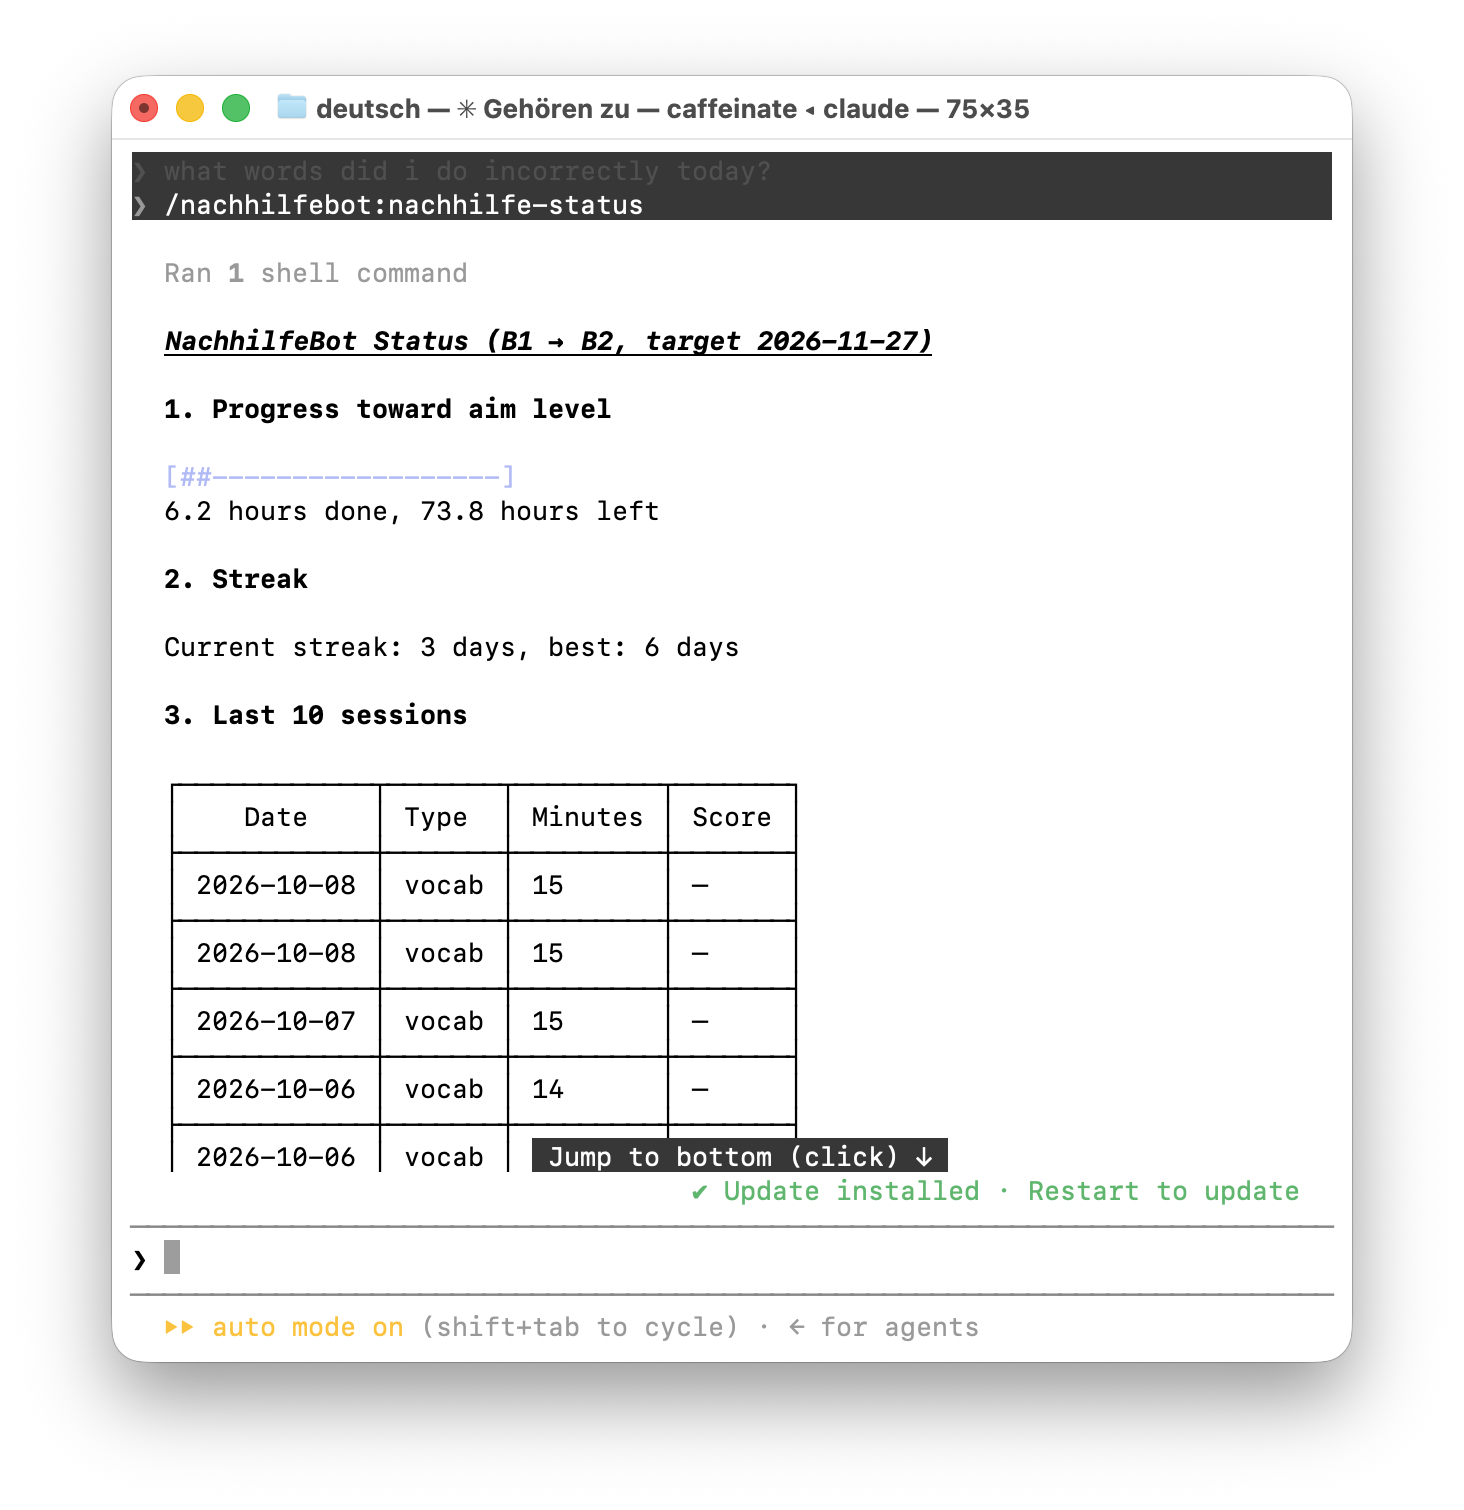
Когда я в новый день запускаю плагин, я понимаю, что должен выполнить несколько сессий по улучшению словарного запаса, пока не закончится проверка полуусвоенных слов и не начнут добавляться новые слова, которых я ещё не знаю. Плагин хранит историю того, насколько хорошо я знаю то или иное слово. Для этого используется алгоритм FSRS (Free Spaced Repetition Scheduler). Коротко говоря, это алгоритм, который позволяет плагину чаще спрашивать те слова, с которыми я чаще ошибаюсь, и изредка проверять, правильно ли запомнились уже освоенные слова.
Также я обязательно делаю одно письменное задание, потому что это идеальный способ с помощью ИИ улучшить именно умение самому воспроизводить контент на изучаемом языке. Формат этого упражнения я сделал схожим с форматом языковых экзаменов: задаётся ситуация, и по ней надо написать письмо.
Остальные навыки, такие как чтение и грамматика, я тренирую намного реже.
В итоге у меня есть комплекс упражнений, о которых не нужно постоянно напоминать Claude. Эти инструкции записаны в исходниках плагина и могут меняться только через обновление плагина. При необходимости в конкретной сессии их можно немного скорректировать по контексту.
Благодаря этому мне не приходится перед учебной сессией тратить когнитивные ресурсы на то, что изучать и как изучать.
Память
Несмотря на то что контекст современных моделей уже измеряется миллионами токенов, это далеко не означает, что модель хорошо помнит весь контекст. Часть контекста уже занята системными промптами модели, часть тратится на взаимоисключающие вводные данные (например, LLM предложил одно, я отказался), бо́льшая часть уходит на сообщения самого Claude. Через некоторое время хочется просто открыть новую сессию и начать с чистого листа с минимумом галлюцинаций.
В таких случаях хочется иметь «твёрдую» память в определённой структуре: чтобы хранилась именно нужная информация в наиболее компактном и удобном для последующей обработки виде. Через плагин для Claude Code это легко реализовать, сохраняя данные, например, в JSON-файле.
Минимизация дрейфа
С ростом объёма данных и инструкций LLM склонна «дрейфовать», то есть отступать от предыдущих инструкций и вести урок по-своему. Это сильно раздражало. Самым неприятным было то, что в начале всё могло идти хорошо, но после того, как накапливались данные, например, за неделю учёбы, обучение отчасти превращалось в борьбу за соблюдение инструкций.
Это была основная причина, по которой я решил написать свой плагин. Задачу я решил, переложив всю возможную логику на программный код Python.
LLM прекрасна тем, что хорошо проверяет тексты и ответы и генерирует качественный, уникальный контент для упражнений. Python прекрасен детерминированностью: код делает ровно то, что запрограммировано, ни меньше и ни больше. Поэтому имело смысл создать плагин для изучения иностранных языков, в котором вся «операционная деятельность» максимально выполнялась бы с помощью Python. Тогда контекст LLM не засорялся бы вспомогательными операциями: записью, чтением и хранением данных, ведением статистики (количество и длительность сессий, количество правильных ответов и т. д.) и многими другими мелочами.
Результат оправдал ожидания: занимаясь по этому плагину уже третью неделю, я не заметил проблемы дрейфа. В идеале хотелось бы, чтобы плагином можно было удобно пользоваться на всём пути от A1 до C2, но даже корректная работа в течение 150 часов обучения была бы вполне достаточной. 150 часов — среднее количество часов по Goethe для перехода на следующий уровень владения языком.
По логике дрейфа быть и не должно: в работе плагина инструкции не копятся, они заданы в исходнике. Накапливающиеся данные (слова из словарного запаса, сессии и т. д.) подаются в LLM от Python порционно.
Публикация плагина
Anthropic предлагает удобный способ опубликовать плагин, если вы хотите, чтобы он был доступен через их маркетплейс. Но для распространения плагина это вовсе необязательно. Если вы опубликуете исходники плагина на GitHub, любой человек с Claude Code сможет установить его такими командами:
claude plugin marketplace add doszhan/nachhilfebot
claude plugin install nachhilfebot@doszhan
Первая команда добавляет GitHub-репозиторий как маркетплейс. Вторая устанавливает сам плагин из этого маркетплейса.
Тем не менее я решил опубликоваться ради интереса и, в какой-то мере, чтобы сравнить с публикацией мобильных приложений.
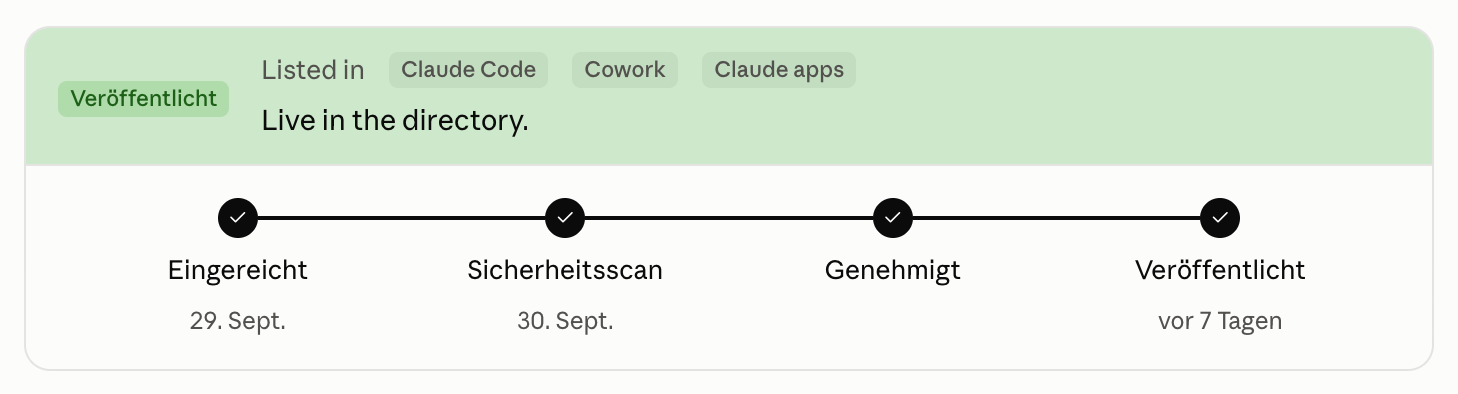
Процесс был достаточно простым. Нужно подготовить и указать политику конфиденциальности, документацию и тип лицензии. Всё это можно разместить прямо в репозитории. Через некоторое время я получил плашку «опубликовано»:
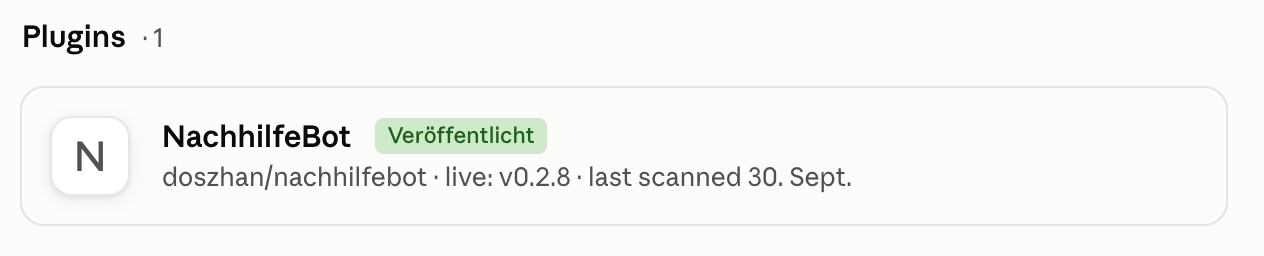
Весь процесс публикации занял всего два дня, хотя я видел жалобы на то, что ревью идёт уже больше нескольких недель.
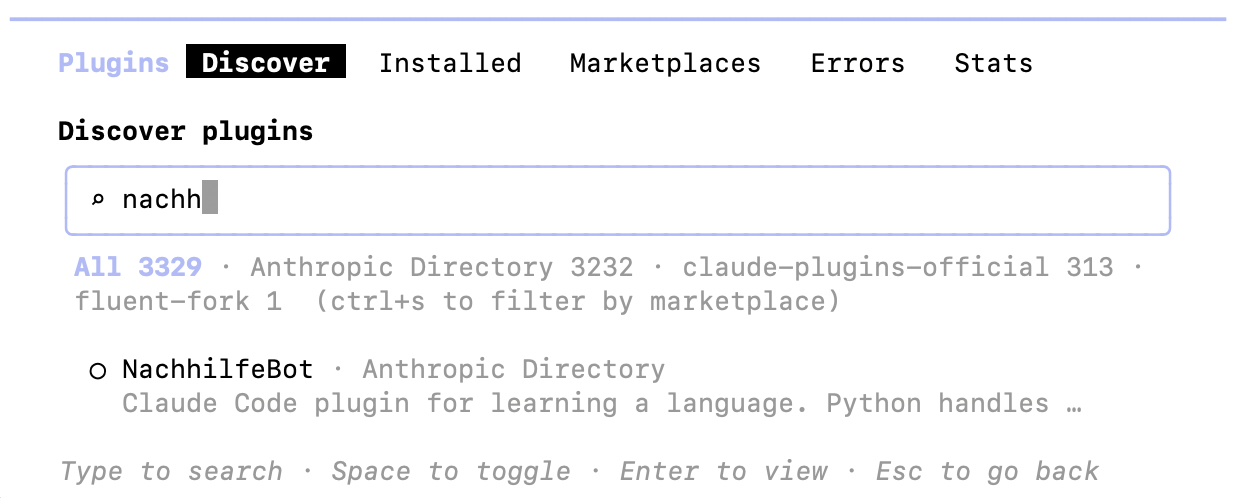
Так выглядит поиск плагина в Claude Code:
Личные выводы
Это был интересный опыт создания и публикации плагина для LLM. Он хорошо показывает, как ИИ может помогать решать конкретные задачи в жизни каждого человека. Этот опыт вдохновил меня на создание другого приложения (уже десктопного) для повышения личной эффективности — о нём наверняка напишу в следующем посте.
Репозиторий с плагином: github.com/doszhan/nachhilfebot